Statistiques descriptives : comment bien décrire ses données ?

Vignette de l’article « Statistiques descriptives : comment bien décrire ses données ? » de DellaDATA.

Les statistiques descriptives constituent généralement la première étape d’une analyse statistique. Avant de comparer des groupes, de rechercher des associations entre des variables ou de construire un modèle, il est indispensable de commencer par regarder et décrire les données dont on dispose.

Cette étape permet notamment de répondre à des questions très simples : combien d’observations sont disponibles ? Certaines données sont-elles manquantes ? Comment se répartissent les différentes catégories d’une variable qualitative ? Quel est l’ordre de grandeur d’une variable quantitative ? Les valeurs sont-elles très dispersées ? Existe-t-il des valeurs particulièrement faibles ou élevées ?

Mais avant même de calculer une moyenne ou un pourcentage, deux étapes sont essentielles : s’assurer que le jeu de données est correctement organisé et identifier la nature des variables qu’il contient.

C’est donc par là que nous allons commencer

1. Bien organiser son jeu de données

Pour pouvoir analyser facilement des données avec un logiciel statistique, tel que R, JASP ou JAMOVI, il est important de les organiser de manière structurée.

La règle générale est assez simple :

  • une ligne correspond à une observation ;
  • une colonne correspond à une variable ;
  • une cellule contient une seule valeur.

Prenons l’exemple d’une étude portant sur 100 patients. Pour chaque patient, nous disposons de son âge, de son sexe, de son poids et de son groupe de traitement.

Le jeu de données pourrait être organisé de cette manière :

idagesexepoidstraitement
00154Femme68.2A
00267Homme81.4B
00345Femme59.7A
00472Homme76.3B

Chaque patient occupe ici une ligne et chaque information recueillie correspond à une colonne.

Cette organisation peut paraître évidente, mais dans la pratique, les fichiers destinés à l’analyse contiennent fréquemment des tableaux conçus davantage pour être lus par une personne que pour être analysés par un logiciel : titres répartis sur plusieurs lignes, cellules fusionnées, plusieurs informations dans une même cellule, sous-tableaux au sein d’une même feuille Excel, etc.

Avant toute analyse statistique, il est donc important de vérifier que les données sont organisées correctement.

À retenir : un tableau destiné à l’analyse statistique n’est pas un tableau de présentation. Sa structure doit avant tout permettre d’identifier clairement les observations et les variables.

2. Identifier la nature des variables

Une fois le jeu de données correctement organisé, la deuxième étape consiste à identifier la nature de chacune des variables.

Cette étape est fondamentale, car les indicateurs statistiques que l’on peut calculer dépendent directement du type de variable étudié.

On distingue tout d’abord deux grandes familles de variables : les variables qualitatives et les variables quantitatives.

Les variables qualitatives

Une variable qualitative décrit une caractéristique ou une catégorie.

Dans notre exemple, sexe et traitement sont des variables qualitatives.

Elles peuvent être nominales, lorsque leurs différentes modalités ne présentent pas d’ordre particulier, ou ordinales, lorsqu’un ordre existe entre les catégories.

Par exemple, un stade de maladie classé en léger, modéré et sévère constitue une variable qualitative ordinale.

Les variables quantitatives

Une variable quantitative correspond à une quantité mesurable et est représentée par une valeur numérique.

L’âge, le poids, la taille ou encore une concentration biologique sont des exemples de variables quantitatives.

On distingue généralement les variables quantitatives discrètes, qui prennent des valeurs dénombrables par exemple un nombre d’hospitalisations, et les variables quantitatives continues, qui peuvent théoriquement prendre n’importe quelle valeur dans un intervalle par exemple le poids ou la taille.

Cette distinction entre variables qualitatives et quantitatives n’est pas seulement une question de vocabulaire. Elle détermine directement la manière dont nous allons décrire les données.

3. Comment décrire une variable qualitative ?

Pour décrire une variable qualitative, on s’intéresse essentiellement aux effectifs et aux pourcentages correspondant à chacune de ses modalités.

Reprenons par exemple la variable traitement. Imaginons que, parmi 100 patients, 48 aient reçu le traitement A et 52 le traitement B.

On pourra présenter cette variable ainsi :

Traitementn%
A4848 %
B5252 %

L’effectif indique donc combien d’observations appartiennent à chaque catégorie, tandis que le pourcentage permet d’apprécier leur importance relative.

Dans une analyse descriptive, on présente généralement les deux informations ensemble : n (%).

Il est également important de vérifier la présence éventuelle de données manquantes, car le dénominateur utilisé pour calculer les pourcentages doit toujours être clairement identifié.

4. Comment décrire une variable quantitative ?

Décrire une variable quantitative nécessite généralement au moins deux informations :

  • un indicateur de position, qui renseigne sur le niveau des valeurs ;
  • un indicateur de dispersion, qui renseigne sur leur variabilité.

Parmi les indicateurs de position, on retrouve notamment la moyenne et la médiane. Parmi les indicateurs de dispersion, les plus couramment utilisés sont l’écart-type et l’intervalle interquartile.

Le minimum et le maximum apportent également des informations utiles sur l’étendue des valeurs observées.

Mais tous ces indicateurs ne racontent pas exactement la même chose.

5. Moyenne et médiane : deux façons de représenter le centre des données

La moyenne est probablement l’indicateur statistique le plus familier. Elle est obtenue en additionnant toutes les valeurs observées puis en divisant cette somme par le nombre d’observations.


\[ \bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i \]


La médiane correspond quant à elle à la valeur qui partage les observations, une fois celles-ci ordonnées, en deux groupes de même effectif : 50 % des observations se situent en dessous de la médiane et 50 % au-dessus.

La différence entre ces deux indicateurs apparaît particulièrement bien lorsque les données comportent des valeurs très élevées ou très faibles.

Imaginons une entreprise composée de dix salariés gagnant chacun 1 200 € par mois et d’un dirigeant gagnant 1 500 €.

Le salaire médian est de 1 200 € et le salaire moyen est d’environ 1 227 €.

Imaginons maintenant que le salaire du dirigeant passe à 6 000 €, sans modification du salaire des dix autres personnes.

Le salaire moyen passe alors à environ 1 636 €, alors que le salaire médian reste égal à 1 200 €.

La moyenne a donc été fortement influencée par la valeur extrême, contrairement à la médiane. C’est l’une des différences essentielles entre ces deux indicateurs.

Il ne faut cependant pas en conclure que la médiane est systématiquement « meilleure » que la moyenne. Ces deux indicateurs décrivent le centre d’une distribution de manière différente et leur pertinence dépend notamment de la distribution des données.

6. L’écart-type : mesurer la dispersion autour de la moyenne

Connaître uniquement la moyenne d’une variable ne suffit pas à décrire les données.

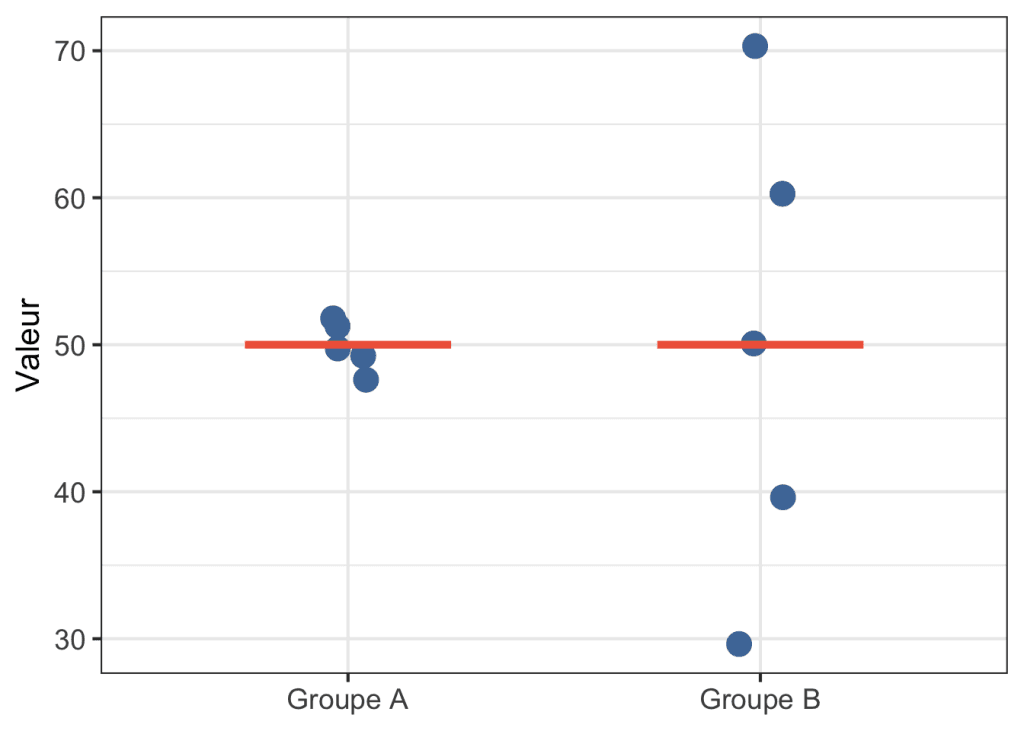
Deux groupes peuvent parfaitement présenter la même moyenne tout en ayant des distributions très différentes.

Imaginons par exemple les deux séries suivantes :

Groupe A : 48, 49, 50, 51, 52 Groupe B : 30, 40, 50, 60, 70

Dans les deux cas, la moyenne est égale à 50. Pourtant, les valeurs du premier groupe sont très proches les unes des autres, alors que celles du second sont beaucoup plus dispersées.

Illustration de l’écart-type : deux groupes ont la même moyenne, mais des dispersions très différentes autour de cette moyenne.

L’écart-type permet de quantifier cette dispersion. Son calcul repose tout d’abord sur les écarts entre chacune des valeurs observées et la moyenne . Ces écarts sont élevés au carré, puis additionnés pour calculer la variance :

$$s^2 = \frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}$$

Plus les observations sont éloignées de la moyenne, plus les écarts sont importants et plus la variance est élevée.

La variance présente cependant un inconvénient : puisqu’elle est calculée à partir d’écarts élevés au carré, elle s’exprime dans l’unité de la variable au carré. Si le poids est exprimé en kilogrammes, par exemple, la variance est exprimée en kg².

Pour retrouver l’unité initiale de la variable, on prend donc la racine carrée de la variance. On obtient alors l’écart-type, noté (s) :

$$s = \sqrt{s^2}
= \sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}$$

L’écart-type s’exprime ainsi dans la même unité que la variable étudiée, ce qui le rend beaucoup plus facile à interpréter que la variance. Plus l’écart-type est élevé, plus les observations sont dispersées autour de leur moyenne. C’est pourquoi moyenne et écart-type sont très souvent présentés ensemble : moyenne ± écart-type

ou sous la forme :

moyenne (écart-type).

7. Médiane, quartiles et intervalle interquartile

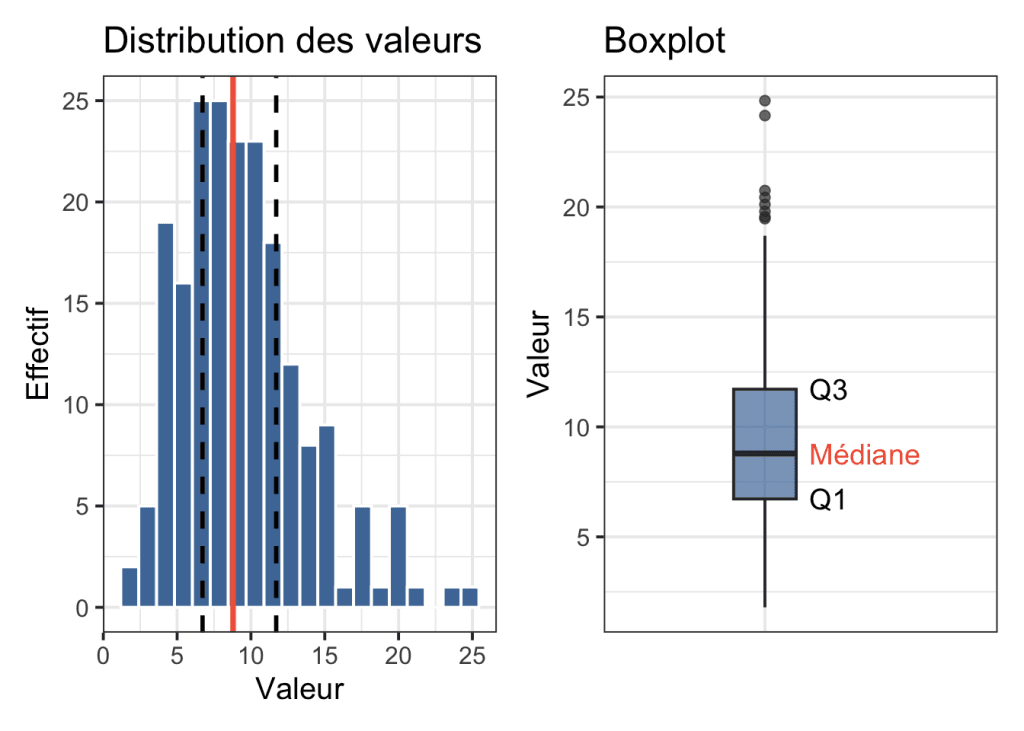
Lorsque l’on utilise la médiane pour décrire la position des données, on s’intéresse généralement également aux premier et troisième quartiles, notés Q1 et Q3.

Le premier quartile correspond au 25e percentile : environ 25 % des observations se situent en dessous de Q1.

La médiane correspond au 50e percentile.

Le troisième quartile correspond au 75e percentile : environ 75 % des observations se situent en dessous de Q3.

L’écart interquartile correspond à la différence entre le troisième et le premier quartile :

IQR = Q3 − Q1

Il mesure donc la dispersion des 50 % centraux des observations.

La médiane et les quartiles sont notamment représentés dans les boîtes à moustaches (boxplots), qui permettent de visualiser rapidement la position, la dispersion et l’éventuelle asymétrie des données.

Illustration de la médiane, des quartiles Q1 et Q3 et de l’écart interquartile à l’aide d’un histogramme et d’un boxplot.

8. Moyenne et écart-type ou médiane et quartiles ?

Pour une variable quantitative, il ne s’agit pas de calculer systématiquement tous les indicateurs disponibles, mais de choisir ceux qui décrivent le mieux les données.

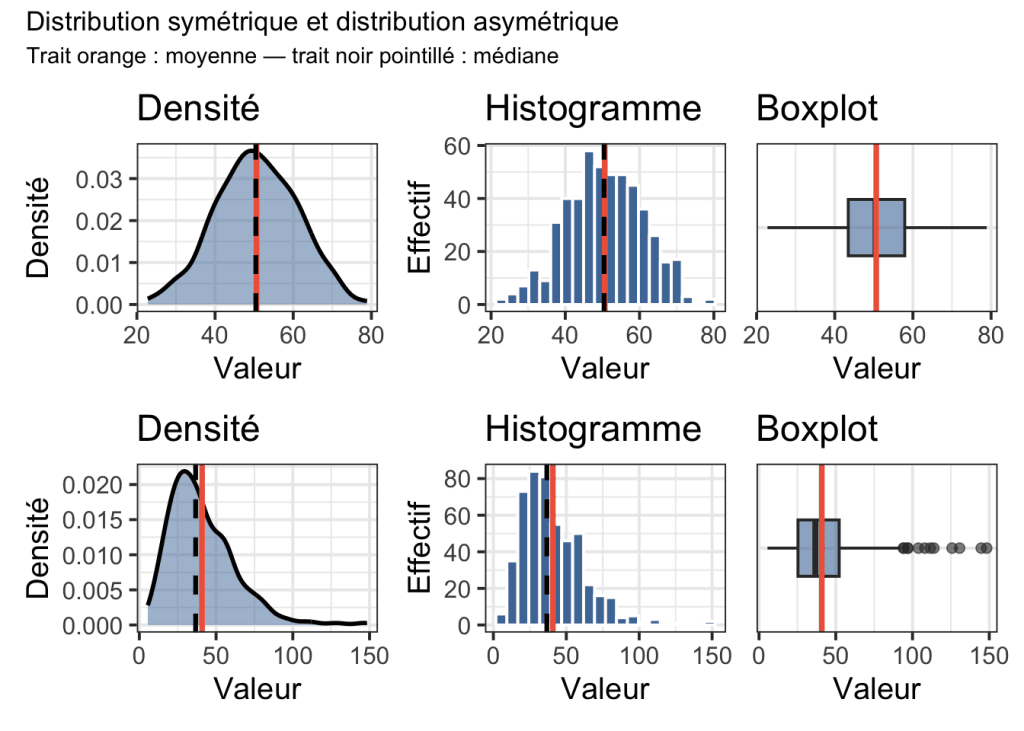
Lorsque la distribution est relativement symétrique et ne comporte pas de valeurs extrêmes très influentes, la moyenne et l’écart-type permettent généralement d’en donner une bonne description.

Lorsque la distribution est fortement asymétrique ou comporte des valeurs extrêmes, la médiane et les quartiles peuvent être plus informatifs, car ils sont moins sensibles à ces valeurs.

La représentation graphique des données est donc particulièrement importante : histogramme, densité ou boxplot permettent de compléter les indicateurs numériques et de mieux comprendre la distribution observée.

Comparaison de la moyenne et de la médiane dans une distribution symétrique et une distribution asymétrique.

9. Ne pas oublier le minimum, le maximum et les données manquantes

Le minimum et le maximum permettent de connaître les valeurs extrêmes observées.

Ils sont également très utiles pour effectuer un premier contrôle de cohérence des données.

Si une variable correspondant à l’âge des participants présente un minimum de −4 ans ou un maximum de 350 ans, il y a probablement un problème dans le jeu de données !

Le nombre de données manquantes constitue également une information descriptive importante. Une moyenne calculée sur 98 observations n’apporte pas exactement la même information si l’étude comportait initialement 100 ou 500 participants.

La description des données doit donc toujours permettre d’identifier le nombre d’observations effectivement disponibles pour l’analyse.

10. Et concrètement, avec R ?

Avec R, il existe de nombreuses façons de réaliser une analyse descriptive. Les fonctions de base de R ou celles du package {dplyr} permettent de calculer précisément les indicateurs souhaités, mais plusieurs packages proposent également des fonctions permettant d’obtenir rapidement un résumé descriptif de l’ensemble d’un jeu de données.


Une première exploration avec skimr

 Le package {skimr} propose la fonction skim(), qui permet d’obtenir en une seule commande une vue d’ensemble d’un jeu de données. Prenons comme exemple le jeu de données iris, disponible directement dans R :

library(skimr)

# Exploration du jeu de données
iris |>
  skim() 
Data summary
Nameiris
Number of rows150
Number of columns5
_______________________ 
Column type frequency: 
factor1
numeric4
________________________ 
Group variablesNone

Variable type: factor

skim_variablen_missingcomplete_rateorderedn_uniquetop_counts
Species01FALSE3set: 50, ver: 50, vir: 50

Variable type: numeric

skim_variablen_missingcomplete_ratemeansdp0p25p50p75p100hist
Sepal.Length015.840.834.35.15.806.47.9▆▇▇▅▂
Sepal.Width013.060.442.02.83.003.34.4▁▆▇▂▁
Petal.Length013.761.771.01.64.355.16.9▇▁▆▇▂
Petal.Width011.200.760.10.31.301.82.5▇▁▇▅▃

La fonction skim() fournit tout d’abord des informations générales sur le jeu de données : nombre d’observations, nombre de variables et type des différentes variables. Elle adapte ensuite les informations présentées à leur nature. Pour les variables quantitatives, elle fournit notamment le nombre de données manquantes, la moyenne, l’écart-type, les quartiles, le minimum et le maximum.

Pour les variables qualitatives, elle indique notamment le nombre de données manquantes et le nombre de modalités.

skim() est donc particulièrement pratique pour réaliser une première exploration rapide du jeu de données. En revanche, elle ne fournit pas directement les effectifs et pourcentages de chacune des modalités d’une variable qualitative.

Construire un tableau descriptif avec gtsummary

Pour obtenir un véritable tableau descriptif comprenant à la fois les variables quantitatives et qualitatives, on peut par exemple utiliser le package {gtsummary}. Avec sa fonction tbl_summary(), quelques lignes de code suffisent :

library(gtsummary)
# Tableau descriptif
iris |>
  tbl_summary() 
CharacteristicN = 1501
Sepal.Length5.80 (5.10, 6.40)
Sepal.Width3.00 (2.80, 3.30)
Petal.Length4.35 (1.60, 5.10)
Petal.Width1.30 (0.30, 1.80)
Species 
    setosa50 (33%)
    versicolor50 (33%)
    virginica50 (33%)
1 Median (Q1, Q3); n (%)

La fonction reconnaît automatiquement la nature des variables et adapte les statistiques présentées. Les variables quantitatives sont résumées à l’aide d’indicateurs de position et de dispersion, tandis que les différentes modalités des variables qualitatives sont présentées sous la forme n (%).

La présence de données manquantes est également prise en compte. On peut demander à les faire apparaître dans le tableau lorsqu’il y en a :

iris |>
  tbl_summary(
    missing = "ifany"
  ) 
CharacteristicN = 1501
Sepal.Length5.80 (5.10, 6.40)
Sepal.Width3.00 (2.80, 3.30)
Petal.Length4.35 (1.60, 5.10)
Petal.Width1.30 (0.30, 1.80)
Species 
    setosa50 (33%)
    versicolor50 (33%)
    virginica50 (33%)
1 Median (Q1, Q3); n (%)

Les statistiques présentées peuvent bien entendu être personnalisées. Par exemple, si l’on souhaite décrire les variables quantitatives par leur moyenne et leur écart-type :

iris |>
  tbl_summary(
    statistic = all_continuous() ~ "{mean} ({sd})",
    missing = "ifany"
  ) 
CharacteristicN = 1501
Sepal.Length5.84 (0.83)
Sepal.Width3.06 (0.44)
Petal.Length3.76 (1.77)
Petal.Width1.20 (0.76)
Species 
    setosa50 (33%)
    versicolor50 (33%)
    virginica50 (33%)
1 Mean (SD); n (%)

On pourrait tout aussi bien choisir de présenter la médiane et les quartiles :

iris |>
  tbl_summary(
    statistic = all_continuous() ~ "{median} [{p25} ; {p75}]",
    missing = "ifany"
  ) 
CharacteristicN = 1501
Sepal.Length5.80 [5.10 ; 6.40]
Sepal.Width3.00 [2.80 ; 3.30]
Petal.Length4.35 [1.60 ; 5.10]
Petal.Width1.30 [0.30 ; 1.80]
Species 
    setosa50 (33%)
    versicolor50 (33%)
    virginica50 (33%)
1 Median [Q1 ; Q3]; n (%)

Le choix entre ces différentes présentations ne doit évidemment pas être automatique : il dépend de la distribution des données, de la présence éventuelle de valeurs extrêmes et, plus généralement, de ce que l’on souhaite montrer.

Et pour décrire les données par groupe ?

Dans de nombreuses analyses, on souhaite également présenter les caractéristiques des individus séparément selon les groupes étudiés. Avec {gtsummary}, il suffit alors d’indiquer la variable définissant les groupes avec l’argument by. Par exemple :

penguins |> 
  tbl_summary(
    by = species,
    statistic = all_continuous() ~ "{mean} ({sd})",
    missing = "ifany"
  ) 
CharacteristicAdelie
N = 1521
Chinstrap
N = 681
Gentoo
N = 1241
island   
    Biscoe44 (29%)0 (0%)124 (100%)
    Dream56 (37%)68 (100%)0 (0%)
    Torgersen52 (34%)0 (0%)0 (0%)
bill_len38.8 (2.7)48.8 (3.3)47.5 (3.1)
    Unknown101
bill_dep18.35 (1.22)18.42 (1.14)14.98 (0.98)
    Unknown101
flipper_len190 (7)196 (7)217 (6)
    Unknown101
body_mass3,701 (459)3,733 (384)5,076 (504)
    Unknown101
sex   
    female73 (50%)34 (50%)58 (49%)
    male73 (50%)34 (50%)61 (51%)
    Unknown605
year   
    200750 (33%)26 (38%)34 (27%)
    200850 (33%)18 (26%)46 (37%)
    200952 (34%)24 (35%)44 (35%)
1 n (%); Mean (SD)

Le tableau présente alors les statistiques descriptives séparément pour chacune des espèces.

Cette possibilité est particulièrement utile pour construire les tableaux descriptifs que l’on retrouve classiquement au début des résultats d’une étude.

Il n’existe pas une seule façon de faire avec R

skimr et gtsummary ne sont que deux possibilités parmi beaucoup d’autres pour réaliser des analyses descriptives avec R. On peut bien sûr construire ses propres résumés avec {dplyr}, en choisissant précisément les statistiques à calculer avec summarise().

D’autres packages proposent des fonctions spécifiquement conçues pour l’exploration et la description des données. Le package {summarytools}, par exemple, fournit dfSummary(), particulièrement pratique pour obtenir rapidement une vue d’ensemble d’un jeu de données, ainsi que freq() pour décrire les variables qualitatives et descr() pour les variables quantitatives. Le package {pastecs} propose quant à lui la fonction stat.desc(), qui permet de calculer en une seule commande de nombreuses statistiques descriptives pour les variables quantitatives.

Ces outils ne répondent pas exactement au même besoin. skim() et dfSummary() sont particulièrement utiles pour explorer rapidement un jeu de données, summarise() ou stat.desc() permettent de calculer des statistiques descriptives choisies, tandis que tbl_summary() est davantage orientée vers la construction d’un tableau descriptif prêt à être présenté dans un rapport ou une publication.

Quel que soit l’outil utilisé, le principe reste cependant le même : avant de calculer des statistiques descriptives, il faut identifier la nature des variables, examiner les données et choisir les indicateurs adaptés à ce que l’on souhaite décrire.

11.Et avec JASP ou Jamovi ?

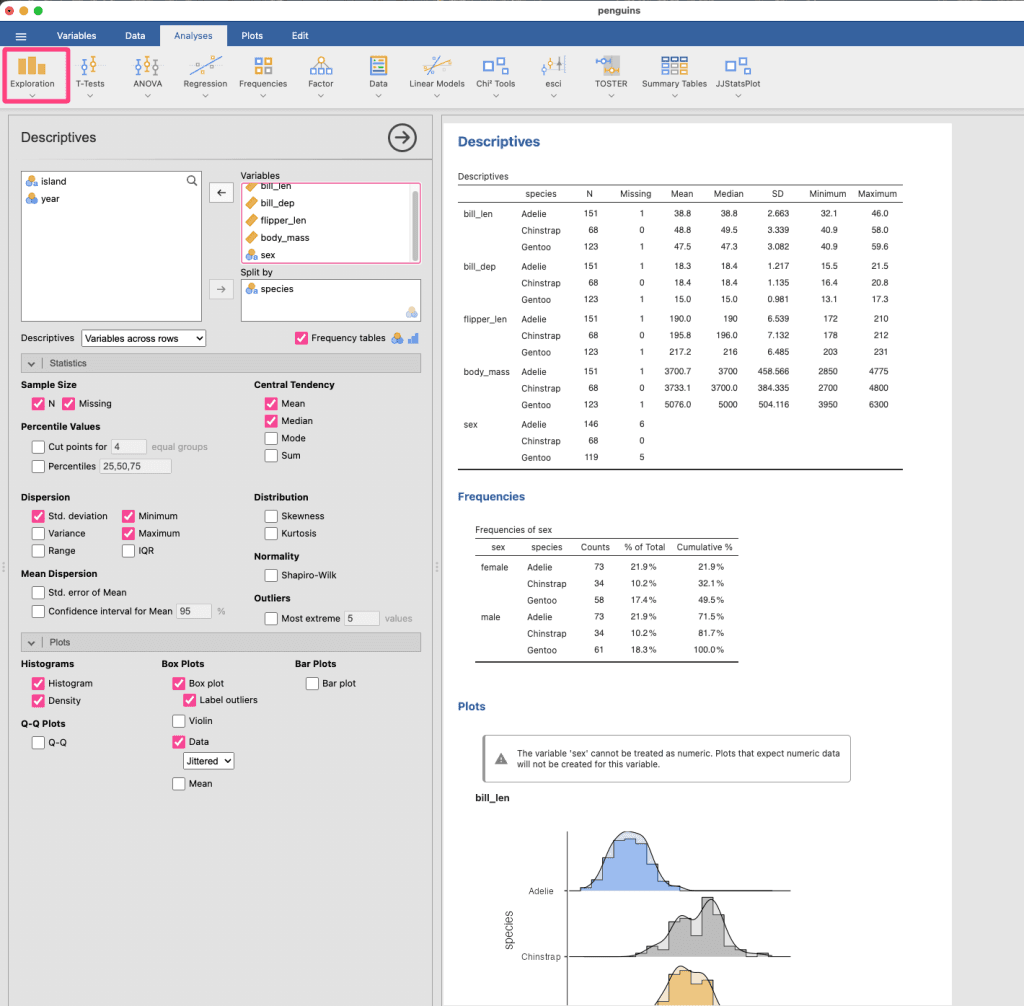
Il n’est bien sûr pas nécessaire d’utiliser R pour réaliser une analyse descriptive. Des logiciels comme JASP ou Jamovi  permettent d’obtenir très facilement les mêmes statistiques à partir d’une interface graphique. La démarche est très similaire dans les deux logiciels : après avoir importé le jeu de données, on sélectionne les variables que l’on souhaite décrire, puis les statistiques et les représentations graphiques que l’on souhaite obtenir.

Dans Jamovi, les analyses descriptives sont accessibles depuis le menu Analyses > Exploration > Descriptives.

Dans JASP, on les retrouve dans le module Descriptives. On peut alors sélectionner les indicateurs à afficher : nombre de données valides et manquantes, moyenne, écart-type, médiane, quartiles, minimum, maximum, etc. Pour les variables qualitatives, il est également possible d’obtenir les effectifs et les pourcentages de chacune des modalités.

Les deux logiciels permettent également de compléter ces indicateurs numériques par des représentations graphiques de la distribution, notamment des histogrammes et des boxplots.

Analyse descriptive dans JAMOVI avec calcul de la moyenne, médiane, écart-type, minimum et maximum et affichage d’histogrammes et de boxplots.

Que l’on utilise R, JASP ou Jamovi, la logique reste donc exactement la même : identifier la nature des variables, examiner leur distribution, puis choisir les indicateurs descriptifs adaptés. Le logiciel permet d’effectuer les calculs ; le choix des statistiques pertinentes et leur interprétation restent, eux, du ressort de l’analyste.

Conclusion

Les statistiques descriptives constituent une étape essentielle de toute analyse de données. Avant de chercher à comparer des groupes, à étudier des associations ou à construire des modèles statistiques, il faut commencer par comprendre les données dont on dispose.

Cette première exploration passe par quelques étapes simples : identifier la nature des variables, vérifier la présence de données manquantes, examiner leur distribution et choisir des indicateurs adaptés. Pour une variable qualitative, on s’intéressera principalement aux effectifs et aux pourcentages ; pour une variable quantitative, on cherchera à décrire à la fois sa position et sa dispersion, à l’aide par exemple de la moyenne et de l’écart-type ou de la médiane et des quartiles.

Les représentations graphiques complètent utilement ces indicateurs et permettent souvent de repérer en un coup d’œil une asymétrie, des valeurs extrêmes ou une dispersion importante qui seraient moins évidentes dans un simple tableau de résultats.

Enfin, que l’on utilise R, JASP ou Jamovi, les outils permettent aujourd’hui d’obtenir très facilement ces statistiques. Mais le logiciel ne choisit pas à notre place : une bonne analyse descriptive repose avant tout sur le choix d’indicateurs pertinents et sur leur interprétation.

Vous souhaitez recevoir les prochains articles ? Je vais progressivement reprendre et compléter mes contenus consacrés aux biostatistiques : statistiques descriptives, comparaisons, tests statistiques, régression…

Inscrivez-vous à la newsletter DellaDATA pour être informé(e) des nouveaux articles et des prochaines formations, et découvrir les ressources que je sélectionne au fil de ma veille autour de R, des biostatistiques et des études cliniques

Vous souhaitez vous former à R en autonomie ?

bien-demarrer-r-rstudio

CAMPUS DELLADATA

Apprendre R à votre rythme

Je propose désormais une formation en ligne pour démarrer avec R et RStudio, pensée pour les profils scientifiques (recherche médicale, biologie, agro, environnement…). D’autres modules arrivent prochainement.

Portrait de Claire Della Vedova, consultante et formatrice en biostatistique et langage R

Je suis Claire Della-Vedova, consultante en biostatistique, méthodologie clinique et expertise R.

J’accompagne les fabricants de dispositifs médicaux et les équipes scientifiques des sciences du vivant dans leurs projets d’évaluation clinique, d’analyse statistique et d’analyse de données sous R.

🎓 Formations professionnelles R et biostatistiques 

🤝 Prestations et accompagnement sur mesure 

📅 Discuter d’un accompagnement ou d’une prestation sur mesure  

Une réponse

  1. Merci Claire pour cette mise à jour et ces rappels.
    Je note que je suis un peu ringard, ne connaissant pas JASP ni JAMOVI !
    Je serai donc fidèle une fois de plus aux prochains bulletins.
    Merci encore

Laisser un commentaire

Votre adresse e-mail ne sera pas publiée. Les champs obligatoires sont indiqués avec *

Fonctions statistiques R

Aide mémoire off'R ;)

Enregistrez vous pour recevoir gratuitement mes fiches « aide mémoire » (ou cheat sheets) qui vous permettront de réaliser facilement les principales analyses biostatistiques avec le logiciel R et pour être informés des mises à jour du site.