
Lorsqu’on présente les résultats d’une étude clinique, on rapporte généralement des moyennes, des pourcentages ou des différences entre deux groupes. Par exemple, on peut indiquer que 60 % des patients ont présenté une amélioration de leurs symptômes après utilisation d’un dispositif médical. Mais peut-on considérer que ce résultat représente exactement ce qui se passerait dans l’ensemble de la population concernée ?
Non, car les résultats d’une étude reposent généralement sur un échantillon de patients et comportent donc une part d’incertitude.
C’est précisément pour tenir compte de cette incertitude que l’on calcule un intervalle de confiance. Dans cet article, je vous propose de voir à quoi sert un intervalle de confiance à 95 %, comment l’interpréter, de quoi dépend sa largeur et comment le calculer avec R, jamovi ou JASP.
Après la mise sur le marché d’un dispositif médical, son fabricant doit continuer à recueillir et à analyser les données cliniques pertinentes pour confirmer sa sécurité et ses performances, vérifier que son rapport bénéfice/risque reste acceptable et identifier d’éventuels risques émergents.
C’est notamment le rôle du suivi clinique après commercialisation, ou PMCF (Post-Market Clinical Follow-up), qui s’inscrit dans la surveillance après commercialisation des dispositifs médicaux.
Imaginons une étude PMCF portant sur un dispositif médical destiné à soulager des douleurs chroniques.
L’un des objectifs est d’estimer la proportion de patients présentant une amélioration cliniquement pertinente de leur douleur après utilisation du dispositif.
La douleur est évaluée sur une échelle de 0 à 100, avant et après utilisation du dispositif. Dans notre exemple fictif, une diminution d’au moins 20 points a été définie dans le protocole comme une amélioration cliniquement pertinente.
Ce seuil est choisi uniquement pour notre exemple. En pratique, la différence minimale cliniquement importante (MCID) doit être justifiée selon l’échelle utilisée, la pathologie et la population étudiée.
Parmi les 100 patients évalués, 60 présentent une amélioration d’au moins 20 points.
La proportion observée de patients améliorés est donc de 60 %. Mais ces 100 patients ne représentent qu’un échantillon de l’ensemble des patients auxquels le dispositif est destiné.
Pour comprendre le problème, distinguons trois notions :
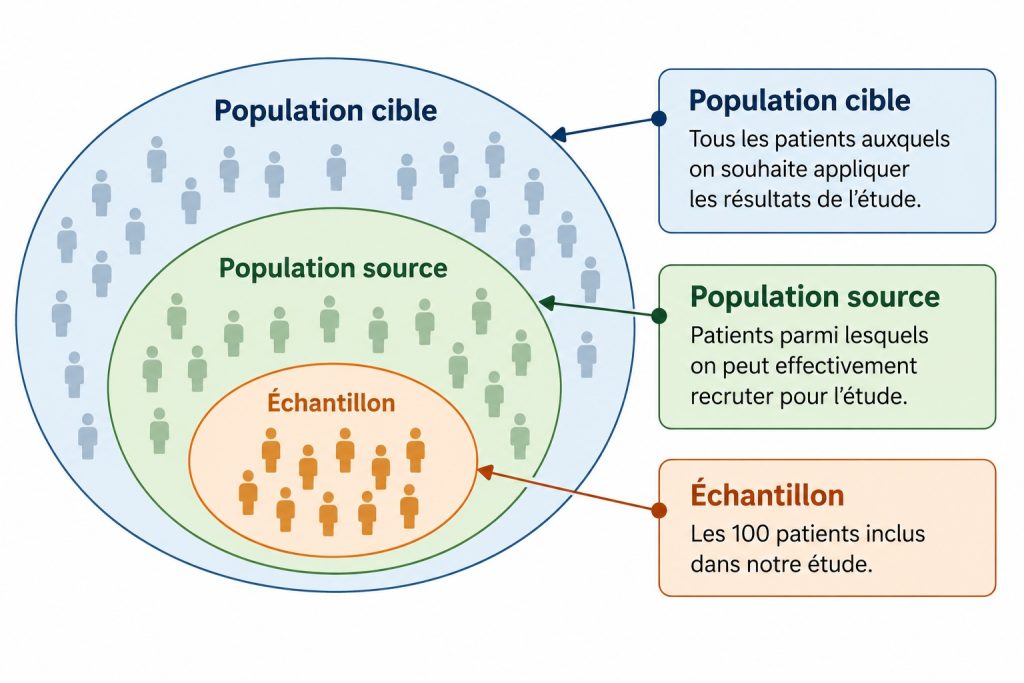
Notre étude porte sur 100 patients. Mais si nous avions recruté 100 autres patients dans les mêmes conditions, aurions-nous obtenu exactement 60 % de patients améliorés ?
Probablement pas. Nous aurions pu observer 57 %, 62 % ou 59 %.
C’est ce qu’on appelle la fluctuation d’échantillonnage : les résultats varient d’un échantillon à l’autre, même lorsque les échantillons proviennent d’une même population.
Les 60 % observés constituent donc une estimation ponctuelle de la proportion de patients améliorés dans la population dont est issu notre échantillon.
Cette estimation comporte une incertitude, que l’intervalle de confiance va nous aider à quantifier.
Un intervalle de confiance est un intervalle calculé à partir des observations d’un échantillon pour estimer un paramètre inconnu de la population.
Ce paramètre peut être une moyenne, une proportion, une différence entre deux groupes ou encore une autre mesure statistique.
Reprenons notre étude PMCF. Sur les 100 patients évalués, 60 ont présenté une amélioration cliniquement pertinente de leur douleur.
Nous obtenons :
Comment interpréter ces résultats ?
Les 60 % correspondent à ce que nous avons effectivement observé dans notre échantillon.
En revanche, nous ne connaissons pas la proportion exacte de patients qui présenteraient une telle amélioration dans la population.
L’intervalle de confiance indique que, compte tenu de nos données et de la méthode statistique utilisée (ici l’approche de Wilson), des proportions comprises approximativement entre 50 % et 69 % restent compatibles avec les résultats de notre étude.
Autrement dit, notre meilleure estimation est de 60 %, mais les données ne permettent pas de déterminer la proportion dans la population avec une précision absolue.
L’intervalle de confiance nous renseigne sur cette précision : plus il est étroit, plus l’estimation est précise.
Mais pourquoi parle-t-on d’un niveau de confiance de 95 % ?
On entend souvent dire : « Il y a 95 % de chances que la vraie valeur se trouve dans l’intervalle calculé. »
Cette formulation est intuitive, mais elle n’est pas rigoureusement correcte dans l’approche fréquentiste classique.
Pour comprendre pourquoi, imaginons que nous connaissions la véritable proportion de patients améliorés dans la population. Supposons qu’elle soit de 60 %.
Nous répétons alors notre étude un grand nombre de fois, en recrutant à chaque fois un nouvel échantillon de patients dans les mêmes conditions.
Pour chaque échantillon, nous calculons un intervalle de confiance à 95 %.
Les intervalles obtenus seront différents, puisque les proportions observées fluctuent d’un échantillon à l’autre.
Certains contiendront la véritable proportion de 60 %, d’autres non.
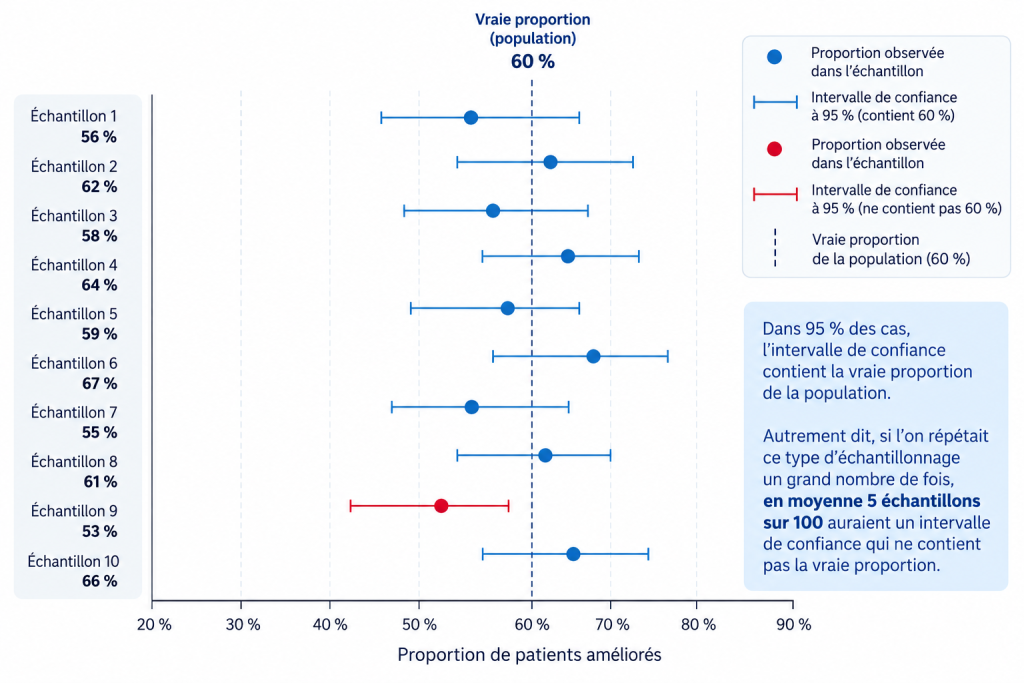
Environ 95 % de ces intervalles contiendront la véritable proportion de patients améliorés dans la population.
C’est ce que signifie le niveau de confiance de 95 % : il correspond à la fréquence avec laquelle les intervalles calculés contiendraient la véritable valeur si nous répétions l’étude un très grand nombre de fois, dans les mêmes conditions.
La largeur d’un intervalle de confiance renseigne sur la précision statistique de l’estimation.
Elle dépend principalement de trois éléments : la taille de l’échantillon, la variabilité du phénomène étudié et le niveau de confiance choisi.
Voyons comment ces facteurs interviennent selon que l’on estime une proportion ou une moyenne.
La taille de l’échantillon
Imaginons que nous observions toujours 60 % de patients améliorés, mais avec des effectifs différents.
| Nombre de patients | Proportion observée | IC à 95 % |
|---|---|---|
| 50 | 60 % | [46,2 % ; 72,4 %] |
| 100 | 60 % | [50,2 % ; 69,1 %] |
| 1 000 | 60 % | [56,9 % ; 63,0 %] |
Intervalles calculés avec la méthode de Wilson, valeurs arrondies.
À proportion identique, l’intervalle se resserre lorsque l’effectif augmente.
La valeur de la proportion
Dans un modèle binomial, la variabilité dépend également de la proportion elle-même.
La variance d’une variable de Bernoulli vaut :
\[p(1-p)\]
Elle est maximale lorsque (p=0,5), c’est-à-dire pour une proportion de 50 %, et diminue lorsque la proportion se rapproche de 0 % ou de 100 %.
Ainsi, à effectif identique, les intervalles de confiance sont généralement plus larges pour des proportions proches de 50 % que pour des proportions proches de 0 % ou de 100 %.
Le niveau de confiance
Enfin, un intervalle de confiance à 99 % est généralement plus large qu’un intervalle à 95 %, lui-même plus large qu’un intervalle à 90 %.
Augmenter le niveau de confiance nécessite généralement d’élargir l’intervalle.
Reprenons notre étude PMCF, mais intéressons-nous cette fois à la diminution moyenne du score de douleur.
Imaginons que nous observions une diminution moyenne de 25 points.
Deux études peuvent obtenir cette même moyenne avec des résultats individuels très différents.
Dans la première, les diminutions du score de douleur sont relativement proches les unes des autres.
Dans la seconde, certains patients présentent une très faible diminution, tandis que d’autres présentent une diminution beaucoup plus importante.
Les deux études ont la même moyenne, mais les données de la seconde sont davantage dispersées.
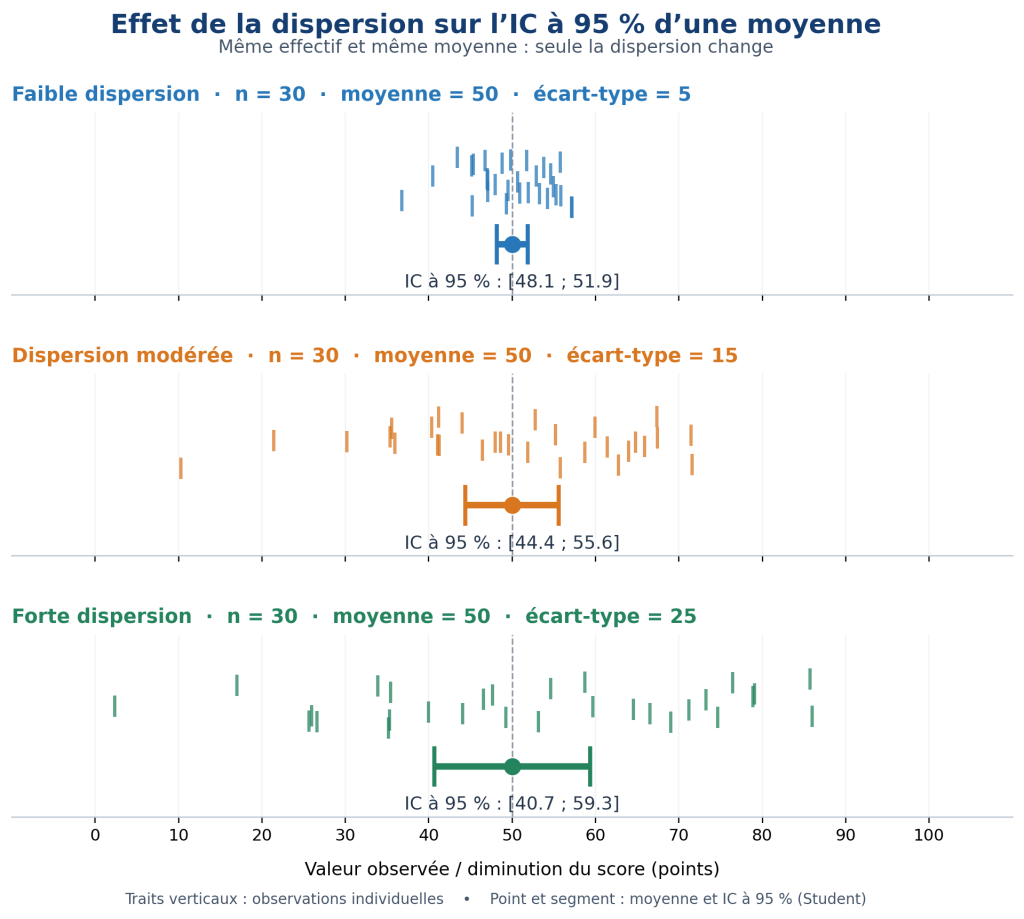
À effectif et niveau de confiance identiques, plus les observations sont dispersées, plus l’intervalle de confiance de la moyenne est généralement large.
Pour une moyenne, l’erreur standard estimée s’écrit :
\[SE(\bar{x})=\frac{s}{\sqrt{n}}\]
où (s) représente l’écart-type des observations et (n) la taille de l’échantillon.
Cette formule montre que l’incertitude augmente avec la dispersion des observations et diminue lorsque l’effectif augmente.
Le niveau de confiance intervient également : un intervalle à 99 % est plus large qu’un intervalle à 95 %.
Un dernier point important : un intervalle étroit ne garantit pas l’absence de biais. Une étude peut produire une estimation très précise, mais incorrecte si les patients sélectionnés ne sont pas représentatifs de la population cible (par exemple, si vous souhaitez estimer la taille moyenne des adolescents de 15 ans, mais que vous les recrutez uniquement dans un club de basket plutôt que dans différents établissements scolaires) ou si les mesures sont biaisées.
Il existe différentes méthodes de calcul. Leur choix dépend du paramètre à estimer, de la distribution des données, de la taille de l’échantillon et des hypothèses statistiques.
Certaines méthodes utilisent les propriétés de distributions de probabilité connues, comme la loi normale, la loi de Student ou la loi binomiale.
Par exemple, sous les conditions appropriées, l’intervalle de confiance d’une moyenne peut être calculé à partir de la loi de Student :
\[\bar{x}\pm t\_{1-\alpha/2,n-1}\times\frac{s}{\sqrt{n}}\]
Cette formule illustre le principe d’une estimation accompagnée d’une marge d’incertitude.
Pour les proportions, plusieurs méthodes existent, notamment les intervalles de Wilson et de Clopper-Pearson.
Toutes les méthodes ne produisent pas exactement les mêmes résultats, et certaines approximations sont moins fiables avec de petits effectifs ou des proportions proches de 0 ou de 1.
Le bootstrap est une méthode de rééchantillonnage qui permet d’estimer l’incertitude d’une statistique à partir des observations disponibles.
Son principe est relativement simple :
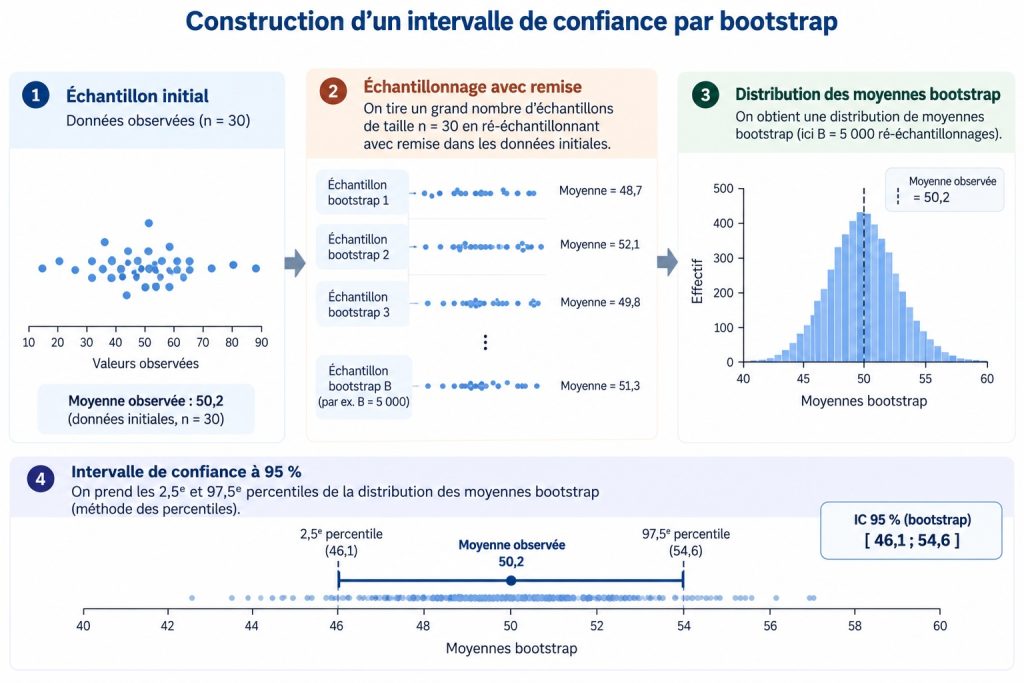
Avec la méthode des percentiles, par exemple, les bornes d’un intervalle à 95 % correspondent aux 2,5e et 97,5e percentiles de la distribution bootstrap.
Le bootstrap peut être particulièrement utile lorsque la distribution d’échantillonnage de la statistique étudiée est difficile à déterminer ou lorsqu’on souhaite estimer l’incertitude d’une statistique complexe.
Il ne constitue toutefois pas une solution universelle : ses performances dépendent notamment de l’effectif, de la structure des données et de la méthode bootstrap utilisée.
Lorsqu’une méthode classique est bien adaptée au paramètre étudié et que ses conditions d’application sont raisonnablement satisfaites, elle constitue généralement un bon choix.
Le bootstrap constitue une alternative intéressante lorsqu’on ne dispose pas d’une formule simple pour calculer l’intervalle de confiance d’une statistique, ou lorsque les méthodes classiques nécessitent des hypothèses difficiles à satisfaire.
C’est notamment le cas pour certaines statistiques comme la médiane, dont l’intervalle de confiance peut être obtenu par bootstrap sans avoir à déterminer explicitement sa distribution d’échantillonnage.
Bonne nouvelle : il n’est généralement pas nécessaire de calculer les intervalles de confiance à la main.
Les logiciels statistiques proposent des fonctions permettant de les obtenir directement.
Reprenons notre étude PMCF : 60 patients améliorés parmi 100 patients évalués.
La fonction prop.test() permet de calculer un intervalle de confiance pour une proportion.
# Nombre de patients améliorés et effectif total
n_ameliores <- 60
n_patients <- 100

# Calcul de l'IC à 95 % (méthode de Wilson)
resultat <- prop.test(
  x = n_ameliores,
  n = n_patients,
  conf.level = 0.95,
  correct = FALSE
)

# Proportion estimée
resultat$estimate

  p
0.6
# Bornes de l'intervalle de confiance
resultat$conf.int

[1] 0.5020026 0.6905987
attr(,"conf.level")
[1] 0.95
Nous obtenons une proportion de 0,60 et un intervalle de confiance à 95 % approximativement égal à [0,502 ; 0,691].
Il suffit de multiplier ces valeurs par 100 pour obtenir les pourcentages.
En désactivant la correction de continuité avec correct = FALSE, nous obtenons ici l’intervalle de Wilson.
Vous trouverez plus d’information sur cette fonction sur cette page :
La fonction binom.confint() du package binom permet également de calculer les intervalles de confiance selon différentes approches :
library(binom)


# IC à 95 % selon toutes les méthodes disponibles
binom.confint(x = 60, n = 100, conf.level = 0.95)

          method  x   n      mean     lower     upper
1  agresti-coull 60 100 0.6000000 0.5019327 0.6906686
2     asymptotic 60 100 0.6000000 0.5039818 0.6960182
3          bayes 60 100 0.5990099 0.5036046 0.6933254
4        cloglog 60 100 0.6000000 0.4972018 0.6883641
5          exact 60 100 0.6000000 0.4972092 0.6967052
6          logit 60 100 0.6000000 0.5013473 0.6911585
7         probit 60 100 0.6000000 0.5019212 0.6921235
8        profile 60 100 0.6000000 0.5023482 0.6925861
9            lrt 60 100 0.6000000 0.5023309 0.6925956
10     prop.test 60 100 0.6000000 0.4970036 0.6952199
11        wilson 60 100 0.6000000 0.5020026 0.69059
Vous trouverez plus d’information sur cette fonction sur cette page .
Pour calculer l’intervalle de confiance à 95 % d’une moyenne, nous pouvons utiliser la fonction t.test() de R.
Cette fonction permet notamment de réaliser un test de Student à un échantillon (one-sample t-test), qui consiste à comparer une moyenne observée à une valeur de référence.
Mais elle fournit également une estimation de la moyenne et son intervalle de confiance, calculé à partir de la loi de Student. Si notre objectif est uniquement de calculer cet intervalle, nous n’avons pas besoin de préciser de moyenne de référence.
# Jeu de données fictif : diminution du score de douleur
donnees <- data.frame(
  patient = 1:20,
  diminution = c(
    12, 18, 25, 21, 30,
    15, 24, 19, 28, 22,
    17, 26, 20, 32, 14,
    23, 27, 16, 29, 22
  )
)

# Moyenne et écart-type
mean(donnees$diminution)

[1] 22
sd(donnees$diminution)

[1] 5.656854
# IC à 95 % de la diminution moyenne du score de douleur
resultat_moyenne <- t.test(
  donnees$diminution,
  conf.level = 0.95
)

# Afficher les résultats
resultat_moyenne


    One Sample t-test

data:  donnees$diminution
t = 17.393, df = 19, p-value = 3.969e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
 19.35251 24.64749
sample estimates:
mean of x
       22
# Moyenne observée
resultat_moyenne$estimate

mean of x
       22
# Bornes de l'intervalle de confiance
resultat_moyenne$conf.int

[1] 19.35251 24.64749
attr(,"conf.level")
[1] 0.95 Dans les études cliniques, les résultats sont souvent présentés sous forme de tableaux récapitulatifs. Le package gtsummary permet de créer facilement ces tableaux à partir d’un jeu de données.
La fonction tbl_summary() calcule les statistiques descriptives (moyennes, écarts-types, effectifs, pourcentages, etc.). Pour y ajouter les intervalles de confiance à 95 %, il suffit d’enchaîner la fonction add_ci() à l’aide du pipe |>.
library(dplyr)
library(gtsummary)

Warning: package 'gtsummary' was built under R version 4.6.1
library(dplyr)


# Sélection des variables cliniques
donnees <- trial |>
  select(age, response)

# Tableau descriptif avec IC à 95 %


trial |>
  select(age, stage) |>
  tbl_summary(
    type = list(stage ~ "categorical"),
    statistic = list(
      all_continuous() ~ "{mean} ({sd})",
      all_categorical() ~ "{n} ({p}%)"
    ),
    digits = list(
      all_continuous() ~ 2,
      all_categorical() ~ 1
    ),
    missing = "no"
  ) |>
  add_ci(
    # Décimales des intervalles de confiance
    style_fun = list(
      all_continuous() ~ label_style_number(digits = 2),
      all_categorical() ~ label_style_percent(digits = 1)
    )
  )
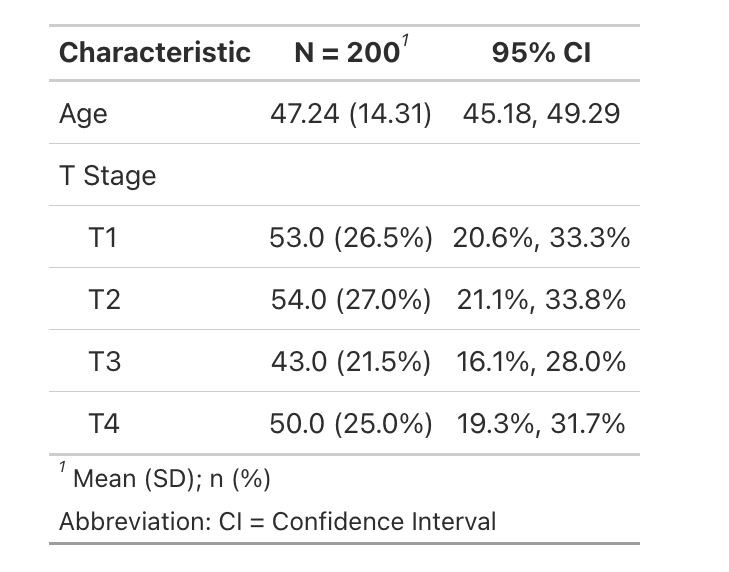
La fonction add_ci() ajoute une colonne contenant les intervalles de confiance des statistiques présentées. Les méthodes de calcul dépendent du type de variable et peuvent être personnalisées.
La méthode de calcul de l’intervalle dépend du type de variable et des options utilisées. Il est donc important de vérifier les méthodes appliquées par défaut et de les adapter si nécessaire.Vous trouverez plus d’informations sur cette fonction ici
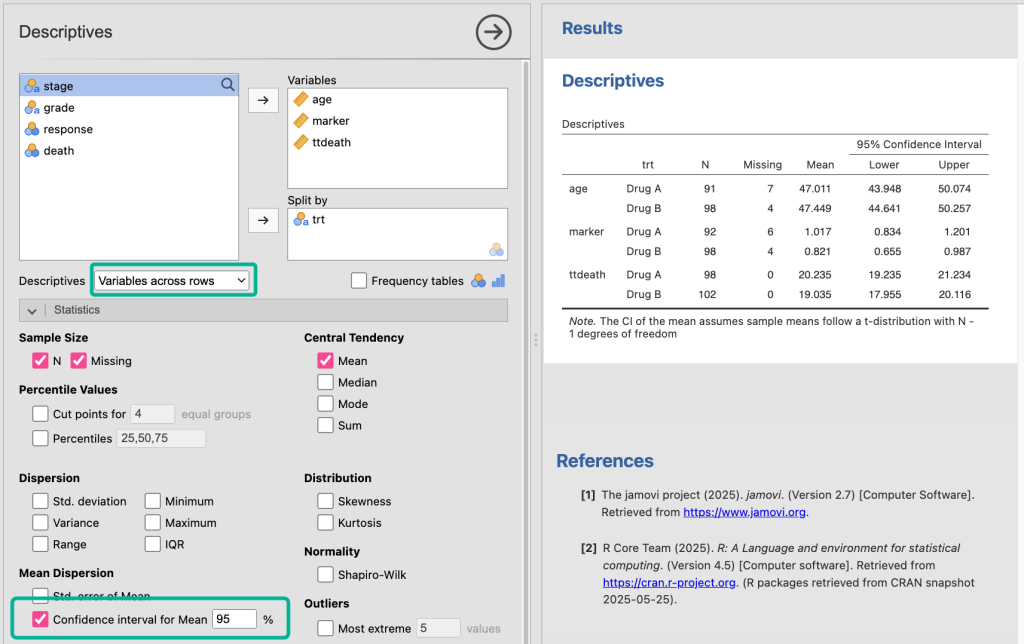
Il est également possible de calculer des intervalles de confiance sans écrire de code, à l’aide d’un logiciel comme jamovi.
Pour calculer l’intervalle de confiance à 95 % d’une moyenne, allez dans le menu Exploration → Descriptives. Sélectionnez la variable quantitative souhaitée, puis, dans la rubrique Statistics, descendez jusqu’à l’option Confidence interval for Mean et cochez-la, comme illustré sur l’image.
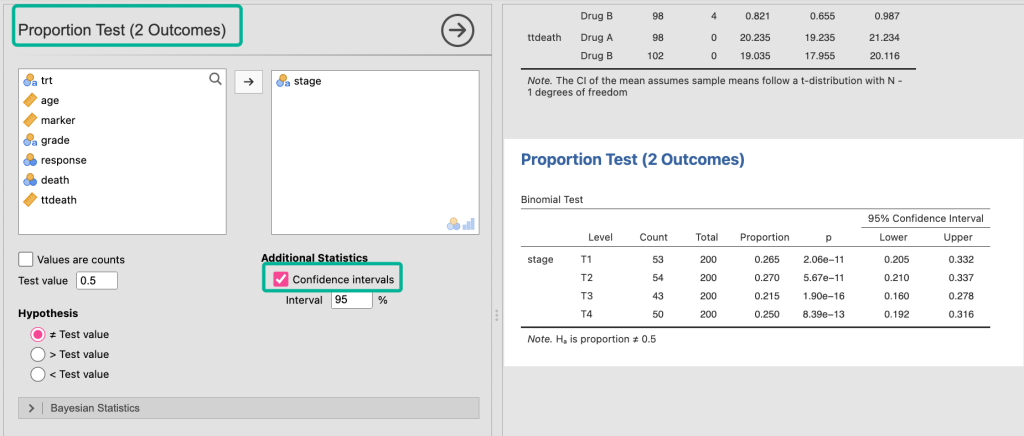
Pour calculer l’intervalle de confiance à 95 % d’une proportion,allez dans le menu Frequencies → Two Outcomes Binomial Test. Sélectionnez votre variable qualitative binaire (deux modalités), puis cochez Confidence interval dans la rubrique Additional Statistics, comme montré sur l’image.
Le logiciel JASP permet également de calculer des intervalles de confiance à partir de son interface graphique, selon un principe similaire.
Vous trouverez plus d’informations sur les logiciels JASP et Jamovi dans l’article Jamovi : Une alternative à R pour les statistiques ?
Revenons à notre étude PMCF.
Nous avons observé une amélioration cliniquement pertinente chez 60 % des patients, avec un intervalle de confiance à 95 % de [50,2 % ; 69,1 %].
L’intervalle nous renseigne sur la précision de la proportion estimée. Mais permet-il de conclure que le dispositif atteint les performances cliniques attendues ?
Cela dépend de l’objectif de l’étude.
Dans certaines études cliniques de dispositifs médicaux, un seuil de performance est défini à l’avance.
Imaginons, par exemple, que le protocole prévoie de démontrer que la proportion de patients améliorés dépasse un seuil minimal fixé à 50 %.
Observer 60 % de patients améliorés ne suffit pas nécessairement pour conclure que cet objectif est atteint.
Selon la règle statistique prévue dans le protocole, on peut notamment examiner la borne inférieure d’un intervalle de confiance approprié, en tenant compte du risque statistique retenu et du caractère unilatéral ou bilatéral de la procédure.
Il faut donc distinguer la performance observée, la précision de son estimation et la démonstration statistique de l’atteinte d’un objectif prédéfini.
Par ailleurs, dans une étude non comparative évaluant les patients avant et après utilisation d’un dispositif, l’amélioration observée ne peut pas nécessairement être attribuée au dispositif lui-même.
L’intervalle de confiance est un outil essentiel, mais il ne remplace ni la qualité méthodologique de l’étude, ni l’analyse de la pertinence clinique des résultats.
Un intervalle de confiance ne sert pas simplement à ajouter deux bornes autour d’une moyenne ou d’un pourcentage.
Il permet d’apprécier la précision d’une estimation et de tenir compte de la fluctuation d’échantillonnage.
Dans notre étude PMCF fictive, 60 % des patients ont présenté une amélioration cliniquement pertinente de leur douleur. L’intervalle de confiance à 95 % [50,2 % ; 69,1 %] apporte une information supplémentaire essentielle pour interpréter ce résultat.
C’est pourquoi les intervalles de confiance occupent une place importante dans les études cliniques, notamment dans l’évaluation des performances des dispositifs médicaux.
Comme le résume très bien cette phrase d’Aquila Williams, découverte sur LinkedIn :
« Un résultat sans son incertitude, c’est une demi-réponse. »
Le bon réflexe : lorsque vous consultez les résultats d’une étude, ne regardez pas uniquement la moyenne, la proportion ou la différence observée. Regardez également son intervalle de confiance.
Et vous, utilisez-vous régulièrement les intervalles de confiance dans vos analyses ? Y a-t-il une méthode de calcul ou une situation particulière que vous aimeriez voir approfondie dans un prochain article ?
N’hésitez pas à me le dire en commentaire !
Comprendre et interpréter les intervalles de confiance fait partie des compétences essentielles pour analyser des données et présenter des résultats statistiques.
Dans mes formations en biostatistiques avec R, nous abordons les principales méthodes d’analyse statistique, leur mise en œuvre dans R et, surtout, l’interprétation des résultats à partir d’exemples concrets.
Découvrez mes formations en biostatistiques pour gagner en autonomie dans vos analyses.
FORMATIONS PROFESSIONNELLES
Apprenez à choisir les méthodes statistiques adaptées à vos données, à réaliser vos analyses avec R, jamovi ou JASP et à interpréter vos résultats grâce à des formations pratiques, avec des exemples concrets.
DellaDATA accompagne également les fabricants de dispositifs médicaux et les équipes de recherche dans la conception de leurs études, la définition des méthodes statistiques, l’analyse des données et l’interprétation des résultats.
EXPERTISE EN RECHERCHE CLINIQUE
DellaDATA accompagne les fabricants de dispositifs médicaux et les équipes de recherche dans la conception des études, la rédaction des plans d’analyse statistique, l’analyse des données et l’interprétation des résultats.
CAMPUS DELLADATA
Je propose désormais une formation en ligne pour démarrer avec R et RStudio, pensée pour les profils scientifiques (recherche médicale, biologie, agro, environnement…). D’autres modules arrivent prochainement.
Je suis Claire Della-Vedova, consultante en biostatistique, méthodologie clinique et expertise R.
J’accompagne les fabricants de dispositifs médicaux et les équipes scientifiques des sciences du vivant dans leurs projets d’évaluation clinique, d’analyse statistique et d’analyse de données sous R.
🎓 Formations professionnelles R et biostatistiques
🤝 Prestations et accompagnement sur mesure
📅 Discuter d’un accompagnement ou d’une prestation sur mesure
Enregistrez vous pour recevoir gratuitement mes fiches « aide mémoire » (ou cheat sheets) qui vous permettront de réaliser facilement les principales analyses biostatistiques avec le logiciel R et pour être informés des mises à jour du site.
2 réponses
TRES DIDACTIQUE ET INTERESSANT COMME PRESENTATION, AINSI JE VOUS EN REMERCIE POUR LA QUALITE DE VOTRE TRAVAIL
PUIS JE L’AVOIR EN PDF ?
Bonjour
Merci pour votre commentaire.
Les articles sont uniquement consultables, mais vous pouvez les imprimer vous même en pdf à partir de votre explorateur.
Bonne continuation